10 倍で 16%
データが十分にあるとき、言語モデルのパラメーターを 2 倍にすると、損失は 5% 減る。10 倍にしても 16% しか減らない。半分にするには、およそ 9000 倍の大きさが要る。2020 年 1 月 23 日に arXiv に投稿された論文「ニューラル言語モデルのスケーリング則」の式に、数を入れると出てくる値である。著者は、ジョンズ・ホプキンス大学と OpenAI に籍を置くジャレッド・カプランと、OpenAI のサム・マキャンドリッシュら 10 人で、研究はこの 2 人が率いた。
損失は、文章の次のトークン(単語や単語の切れ端)をどれだけうまく当てたかの物差しである。正しいトークンに確率 を割り当てたら を数え、テスト用の文章全体で平均する。これが交差エントロピーで、単位はナット(自然対数で測った情報量)になる。論文が調べたいちばん大きな 15 億パラメーターで、式の値は 2.30 ナットになる。 なので、平均すると次のトークンを 10 個ほどの候補まで絞った当て方にあたる。いちばん小さな 768 パラメーターでは 6.93 ナットで、候補はおよそ 1000 個残る。
減り方は小さい。けれども、その減り方は崩れなかった。パラメーター数で 6 桁、計算量で 8 桁にわたって、損失は両対数のグラフで 1 本の直線に沿って下がった。要旨によれば、7 桁を超えて続く傾向もある。モデルの大きさを決めれば、作る前に損失が読める。2022 年のホフマンらの論文は、この結果を受けて、分野がより大きなモデルを作り続けてきたと振り返っている。
論文は、直線がどこまでも続くとは書いていない。文章には当てようのない偶然が残るので、損失は 0 まで下がらない。カプランらは式を先へ延ばし、矛盾に気づいた。計算量を最も効率よく使ったときの直線と、そのとき使えるデータの量から決まる下限が、計算量で 1 万ペタフロップス日、パラメーターで 1 兆ほどの所で交わってしまう。1 ペタフロップス日は、1 秒に 回の計算を 1 日続けた量である。式はそこまでに必ず崩れる。論文は、トランスフォーマーで作る言語モデルはこの交点のあたりで性能の上限に届くのかもしれない、と推測した。そこでの損失 1.7 ナットは、自然の言葉が 1 トークンあたりに持つエントロピーのおおよその値かもしれない、とも述べている。どの数字も上下に 1 桁ほど動きうると断ったうえでの推測である。
2 年後、配分の目安が書き換わった。カプランらの指数では、計算量を 10 倍にするとき、モデルを 5 倍あまりに大きくし、データは 2 倍弱しか増やさない。2022 年 3 月、DeepMind のジョーダン・ホフマンら 22 人は、400 を超えるモデル(パラメーターは 7000 万から 160 億あまり)を学習させ、モデルとデータを同じ割合で増やすべきだと結論した。同じ計算量で比べると、4 分の 1 の大きさのモデル Chinchilla に 4 倍のデータを読ませたほうが、2800 億パラメーターの Gopher より幅広い課題で成績がよかった。
次の 1 文字を当てる実験から
文章の続きを当てる確率で言葉の性質を測る考えは、クロード・シャノンにさかのぼる。1951 年 1 月の『ベル・システム技術雑誌』に載った論文「印刷された英語の予測とエントロピー」で、シャノンは人に英文の続きを 1 文字ずつ当てさせた。当てる人の知らない短い一節を選び、次の文字を当てさせる。外れたら当たるまで続け、何回目で当たったかを書き留める。空白も 1 文字に数えるので、文字は 27 種類ある。例に示された 102 文字では、79 文字が 1 回目で当たった。前の 100 文字ほどが分かっているときの英語のエントロピーは、1 文字あたり 0.6〜1.3 ビットと見積もられた。謝辞には、実験を手伝った人としてメアリー・E・シャノン夫人と B・M・オリヴァーの名がある。
学習に使う例の数と誤差の関係は、理論からも調べられた。1992 年、甘利俊一らは雑誌『ニューラル・コンピュテーション』の論文で、例を 個学んだ機械が新しい例を誤る確率は、条件によって 、、 などのべき乗で減ると導き、4 つの型に分けた。ベイズの考え方に、統計力学で使う近似を組み合わせた解析である。
実際のニューラルネットワークで測ると、減り方はずっと緩かった。2017 年 12 月、バイドゥ・リサーチのジョエル・ヘスネスら 9 人は、機械翻訳・言語モデル・画像の分類・音声認識の 4 つの分野で、学習データを 2 倍ずつ増やして誤差を測った。データの量ごとに、モデルの大きさも選び直している。どの分野でも誤差はデータの量のべき乗で下がり、指数は −0.07 から −0.35 の間に収まった。理論の −0.5 や −1 よりずっと小さい。単語を当てる言語モデルの指数は −0.066 で、ネットワークの構造を変えてもほぼ同じだった。構造の工夫は直線を下へずらすが、傾きは変えないように見える。著者らは学習曲線を 3 つの区間に分けた。データが少なすぎると当て推量と変わらず、多いと減らせない誤差に近づいて頭打ちになる。べき乗で下がるのはその間である。
カプランらは、同じ問いを言語モデルに絞り、パラメーター数 ・データの量 ・学習の計算量 の 3 つを別々に動かした。学習の文章は WebText2 で、掲示板サイト Reddit で評価が 3 以上の投稿のリンク先から集めた。量は 96 GB、約 229 億トークンである。モデルは、文章を前から順に読んで次を当てるトランスフォーマー(注意機構を重ねたネットワーク)である。パラメーターは 768 から 15 億まで、データは 2200 万から 230 億トークンまで変えた。パラメーターの総数が同じなら、層の数と幅の比を 40 倍変えても、損失の差は数パーセントにとどまった。効いたのは形ではなく規模である。
3 つの量ごとの式が、論文の冒頭に並ぶ。データが十分にあるときのパラメーター数の式が、この記事の式である。
データの量で決まるときは で、、 トークン。計算量を最もよく配分したときの指数は 0.050 である。 には、トークンを数のベクトルに変える埋め込みの部分を含めない。含めると、層の数ごとに点の並びがばらけた。論文は、 などの値は語彙やトークンの切り方で変わるので、それ自体に根本の意味は無いと断っている。2 つの量を 1 つにまとめた式も示した。
当てはめた値は 、、、 で、データを 1024 分の 1(約 2000 万トークン)まで減らした場合を除いて、測った点によく合った。
両対数の直線と、データの壁
この式は理論から導いたものではない。論文の付録は、どのスケーリング則にもしっかりした理論の裏付けがまだ無いと認めている。ここでは、式の形から言えることを 1 行ずつ確かめ、次にホフマンらの式から計算量の配分を導く。
-
両辺の常用対数をとる。 は の 1 次式なので、両対数のグラフでは傾き の直線になる。
-
を 倍にした値との比をとると、 も も消える。
-
どこから測っても、10 倍ごと、2 倍ごとに同じ割合で減る。
-
損失を半分にする倍率は、 を解いて求める。
-
でデータを限りなく増やすと、第 2 項が消えてこの記事の式に戻る。
-
逆にモデルを限りなく大きくすると、第 1 項が消え、データの量だけで決まる床が残る。
-
2 つの項が等しくなる所が、直線から曲がり始める目安になる。
-
なので、要るデータはモデルの大きさの 0.74 乗で増える。モデルを 8 倍にするなら、データは 5 倍ほどでよい。
論文はこの形を 3 つの決まりから選んだ。語彙を変えると損失全体が定数倍になること、片方を限りなく大きくするともう片方だけの式に戻ること、データが限りなく多い所で の整数乗に展開できることである。3 つ目は根拠が弱いと論文自身が書く。過学習の度合い が の組み合わせだけで決まることを実験で確かめ、この度合いを乱数の種による損失のばらつき(0.02 ほど)に収める条件として を示した。
ホフマンらは別の形を当てはめた。 は文章そのもののエントロピーにあたり、どれだけ大きくしても減らせない部分である。
計算量を に固定して、損失がいちばん小さくなる を求める。
-
を代入する。
-
で微分して 0 とおく。
-
両辺に を掛けて整理する。
-
最もよいモデルの大きさとデータの量は、どちらも計算量のべき乗になる。
-
丸めた値を入れる。
この方法で論文が報告する値は 0.46 と 0.54 で、丸めた と から出すと少しずれる。論文は別の 2 つの方法でも、モデルの指数 0.49〜0.50、データの指数 0.50〜0.51 を得た。カプランらの 0.73 と 0.27 とは大きく違う。ホフマンらは食い違いの理由として、カプランらがどのモデルも同じトークン数と同じ学習率のスケジュールで学習させたことと、調べたモデルの多くが 1 億パラメーターに満たない小さなものだったことを挙げている。
打った点から式を組み立てる
両対数のグラフに打った点へ直線を引き、その直線から式の形を組み立てる。切片を とする。
-
点に当てはめた直線を式に書く
-
係数を対数の中へ移す
-
両辺を 10 の指数にする
-
定数を と置く
-
同じ指数の積をまとめる
4 の置き方から になる。論文の と から逆に切片を出すと、 である。 を入れると ナットで、5 万 257 種類のトークンから当て推量で選んだときの ナットより悪い。測った範囲の外まで直線を延ばしても、意味のある値は出ない。 も同じで、損失が 1 ナットになる所まで直線を延ばした位置にすぎない。
予算から逆に読む
計算量を見積もる。 カプランらは、学習の計算量を 1 トークンあたり 回の浮動小数点演算と見積もった。前向きに通すのに 回、誤差逆伝播法で後ろへ戻る計算がその 2 倍ほどかかるからで、全体では になる。10 億パラメーターのモデルを 202 億トークンで学習させると 回で、1 ペタフロップス日( 回)の 1.4 倍にあたる。毎秒 回の計算を休まず続けても、1 日半近くかかる。
同じ予算で 2 つのモデルを比べる。 Gopher は 2800 億パラメーターを 3000 億トークンで、Chinchilla は 700 億パラメーターを 1.4 兆トークンで学習した。 で見積もると 回と 回で、ほぼ同じ規模である。1 パラメーターあたりのトークンは、Gopher が 1.1、Chinchilla が 20 になる。ホフマンらの表 3 でも、10 億パラメーターなら 202 億トークン、100 億なら 2051 億トークンと、20 倍前後が並ぶ。57 分野の問題からなる試験 MMLU で、Chinchilla の平均の正答率は 67.6% で、Gopher の 60.0% を 7.6 ポイント上回った(要旨では 67.5%)。モデルが小さいぶん、使うときの計算も少なくて済む。
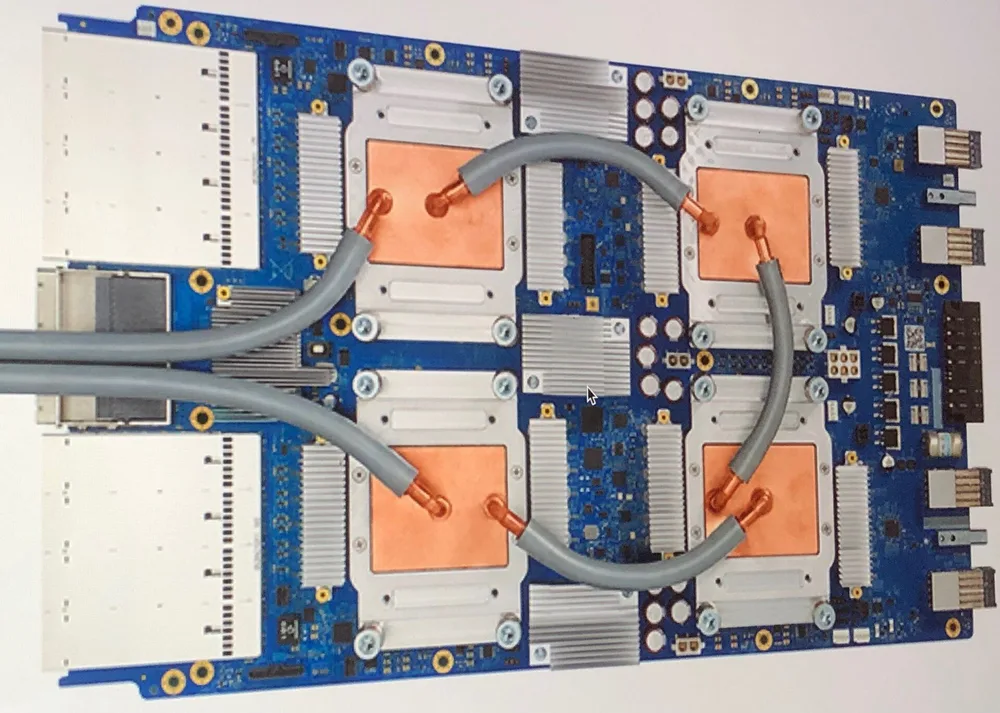
ホフマンらの論文のモデルは、すべて Google の TPUv3 と TPUv4 で学習している。大きなモデルはふつう一度しか学習させられないので、予算に合う大きさを前もって正しく見積もることが欠かせない、と論文は冒頭で述べる。
小さく試して、大きい方を当てる。 2023 年 3 月に公開された GPT-4 の技術報告によると、OpenAI は計算量が GPT-4 の 1 万分の 1 以下のモデルを同じ方法で学習させ、減らせない損失の項を加えた を当てはめた。学習が始まってすぐ、途中の結果を使わずに最終の損失を予測し、予測は高い精度で当たった。
直線から外れたら疑う。 ヘスネスらは、単語と文字の言語モデルの点が、10 億語のベンチマークの 10% と 2% の所で直線から離れ始めたのを、設定を見直す合図にした。大きなモデルでバッチサイズと学習率を上げると、ずれの多くが埋まった。直線は、学習の不具合を見つける物差しにもなる。
指数と予算を手で計算する
例題 1基本1 割減らす倍率と 1000 倍
損失が 、 に従うとする。
(1) 損失を 10% 減らすには、パラメーター数を何倍にすればよいか。
(2) 1000 倍にすると、損失は何 % 減るか。
解説を見る
(1) 倍にしたときの比は によらず である。 を について解く。 を使う。
約 4 倍にすればよい。 で確かめられる。
(2) 1000 倍は 10 倍を 3 回重ねたものなので、10 倍ごとの比 を 3 回掛ける。
損失は約 40.8% 減る。1000 倍にしても、半分にはならない。
例題 2基本2 点から指数を読む
ある系列のモデルで、 のとき損失が 3.37 ナット、 のとき 2.38 ナットだった。損失が のべき乗に従うとする。
(1) 指数 を求めよ。
(2) 同じ直線の上で、 の損失を予測せよ。
解説を見る
(1) 両対数のグラフで 2 点を結ぶ直線の傾きが である。横の差は になる。
およそ 0.076 で、カプランらの値とほぼ同じである。
(2) から は 100 倍なので、比は である。
予測は約 1.68 ナットになる。データが足りなければ、実際の損失はこれより上で頭打ちになる。
例題 3大学データの床と過学習の度合い
カプランらの を、、、、 で使う。データは トークンに固定する。
(1) モデルを限りなく大きくしたときの、損失の床を求めよ。
(2) のときの と を求め、過学習の度合い を出せ。
解説を見る
(1) 第 1 項は 0 に近づくので、第 2 項だけが残る。 を使う。
どれだけモデルを大きくしても、損失は約 2.74 ナットより下がらない。
(2) 第 1 項の中身を先に求める。 である。
第 2 項は で、2 つはほぼ同じ大きさになる。
データが無限なら、第 2 項が 0 になる。
過学習の度合いは で、損失は約 7% 上がる。2 つの項がほぼ等しいので、この はちょうど直線から曲がり始める所にある。
例題 4大学過学習を避けるデータの量
カプランらは、過学習の度合い を 0.02 ほどに抑える目安として を示した。
(1) のとき、要るトークン数を求めよ。
(2) のときに要るトークン数を求め、WebText2(約 229 億トークン)の何倍にあたるかを答えよ。
解説を見る
(1) 指数を先に計算する。 なので である。
約 230 億トークンで、WebText2 の約 229 億トークンとほぼ同じである。10 億パラメーターより小さいモデルなら WebText2 で過学習をほとんど起こさずに学習できる、という論文の記述と合う。
(2) なので である。
約 6900 億トークンで、WebText2 の約 30 倍になる。モデルは (1) の 100 倍だが、データは 倍で済む。
例題 5大学同じ予算の 2 つのモデル
ホフマンらの (、、、、)と を使う。
(1) Gopher(、)と Chinchilla(、)の計算量を求めよ。
(2) 2 つのモデルの損失を式で求めて比べよ。
(3) 計算量を 10 倍にするとき、損失をいちばん小さくするには と をそれぞれ何倍にすればよいか。証明の手順 13 の指数を使え。
解説を見る
(1) どちらも に入れる。
ほぼ同じ規模の計算量である。
(2) Gopher では 、 になる。
Chinchilla では 、 になる。
Chinchilla のほうが約 0.06 ナット低い。Gopher はデータの項 0.251 が大きく、データ不足で損をしている。
(3) 指数は と である。
は約 2.8 倍、 は約 3.5 倍にする。 で、計算量の 10 倍と合う。カプランらの指数 0.73 と 0.27 なら、 は約 5.4 倍、 は約 1.9 倍になる。
目盛りを替えると直線が見える
どの図の値も論文の式から計算したもので、測った点そのものではない。
1 桁ずつ大きくしてみる
点はパラメーター数を から まで 1 桁ずつ上げていき、通った所に丸を残す。「データの量」を限りなく多くすると、丸は傾き −0.076 の直線に並び、1 桁ごとの比はいつも 0.839 になる。データを や トークンに減らすと、曲線は直線から離れて点線の床に沿って横ばいになり、斜線の分だけ損をする。つまみで を選ぶと、その大きさへ移る。
予算・ことば・気体の法則
- 情報科学 交差エントロピーの損失は、データそのもののエントロピーと、モデルの予測とのずれ(KL ダイバージェンス)の和に分けられる。2020 年 10 月、トム・ヘニガンやカプランらは、画像・動画・画像と文章の組・数学の問題の 4 つでも、損失がべき乗に定数を足した形で下がると報告し、定数の部分をデータのエントロピーの見積もりとして読んだ。
- 言語学 シャノンは人に続きを当てさせて、英語のエントロピーを 1 文字あたり 0.6〜1.3 ビットと見積もった。WebText2 では 1 トークンが平均 4.3 文字なので、カプランらが推測した 1 トークンあたり 1.7 ナットは、1 文字あたり約 0.57 ビットにあたる。文字の種類も文章も違うので目安にすぎないが、シャノンの見積もりの下の端 0.6 をわずかに下回る(シャノンの情報エントロピー)。
- 物理学 カプランらは考察で、この関係を、気体の細かな中身によらずに圧力・体積・温度を結ぶ理想気体の状態方程式になぞらえた。観測した「熱力学」の下にある「統計力学」を見つけたい、とも書いている。
- 経済学 規模を増やすほど 1 単位あたりの効き目が落ちるのは、収穫逓減にあたる。カプランらは、経済のなめらかな成長から個々の技術が見えないように、損失のなめらかな改善も質の変化を隠しているかもしれない、と述べた。
- 数学 どの でも が だけで決まる連続な正の関数は、べき乗 に限られる。尺度を変えても形が変わらないこの性質を、スケール不変という。両辺の対数をとれば、対数の法則で 1 次式になる。
参考文献
- J. Kaplan, S. McCandlish, T. Henighan, T. B. Brown, B. Chess, R. Child, S. Gray, A. Radford, J. Wu, D. Amodei, "Scaling Laws for Neural Language Models", arXiv:2001.08361 (2020).
- J. Hestness, S. Narang, N. Ardalani, G. Diamos, H. Jun, H. Kianinejad, M. M. A. Patwary, Y. Yang, Y. Zhou, "Deep Learning Scaling is Predictable, Empirically", arXiv:1712.00409 (2017).
- J. Hoffmann, S. Borgeaud, A. Mensch et al., "Training Compute-Optimal Large Language Models", arXiv:2203.15556 (2022).
- C. E. Shannon, "Prediction and Entropy of Printed English", Bell System Technical Journal 30 (1951), 50-64.
- S. Amari, N. Fujita, S. Shinomoto, "Four Types of Learning Curves", Neural Computation 4 (1992), 605-618.
- T. Henighan, J. Kaplan, M. Katz, M. Chen et al., "Scaling Laws for Autoregressive Generative Modeling", arXiv:2010.14701 (2020).
- OpenAI, "GPT-4 Technical Report", arXiv:2303.08774 (2023).